🔥 正在热议(多家媒体同时报道的事件)
 时政法广中文
时政
法广中文
特朗普:将很快决定是否恢复对伊朗大规模军事行动
曾在中期选举前称不会选前攻打伊朗的美国总统特朗普周四在白宫对媒体表示:他将很快决定是否恢复对德黑兰的大规模军事行动。还说:伊朗不会拥有核武器。他们自己知道这一点,我也知道。
 军事Breaking D
军事
Breaking Defense
突发
错过了 AUSA 2026?从 Breaking Defense 的免费电子书中了解真相
原文:Missed AUSA 2026? Get the Ground Truth from Breaking Defense’s free eBook
在我们的 AUSA 2026 行动后报告中了解会议的重大新闻、陆军优先事项和行业发展。免费下载,无需注册。
 财经华尔街见闻
财经
华尔街见闻
1998 VS 2000,高盛主管:AI抛售更像LTCM危机而非互联网泡沫,但关键问题尚未解答
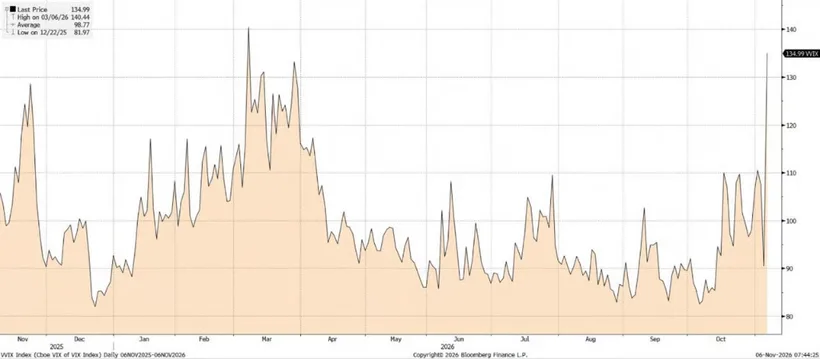
市场正在经历一场关于历史先例的激烈辩论:这究竟是1998年长期资本管理公司(LTCM)危机式的流动性冲击,还是2000年互联网泡沫破裂的序幕?高盛Delta One交易主管Rich Privorotsky倾向于前者,但他自己也承认,决定性答案尚未到来。 周四,纳斯达克单日暴跌5.5%,费城半导体指数重挫12%,标普500下跌4.4%,创下2025年4月以来最大单日跌幅。高盛波动性恐慌指数当日触及10分满分中的9.3分,VVIX单日飙升近45点,创有史以来第二大单日涨幅,仅次于2018年的"波动末日"事件。 触发因素是民主党横扫选举后市场对数据中心建设前景的重新定价,导火索是德克萨斯州等多个州对数据中心建设的潜在监管限制。 这场抛售引发的核心问题,正在成为每一位基金经理的灵魂之问:AI投资热潮的基本逻辑是否依然完好,还是市场正在揭示一个在经济上根本站不住脚的叙事? 程序主导的机械性抛售 周四
 科技Techmeme
科技
Techmeme
埃隆·马斯克 (Elon Musk) 表示,本季度美国政府合同将占 SpaceX 收入的 10% 以下,低于上季度的 16.6%,到 2025 年将占 20% 左右(彭博社)
原文:Elon Musk says US government contracts will account for under 10% of SpaceX's revenue this quarter, down from 16.6% last quarter and around 20% in 2025 (Bloomberg)
彭博社:埃隆·马斯克表示,本季度美国政府合同将占 SpaceX 收入的 10% 以下,低于上季度的 16.6%,到 2025 年将占 20% 左右——埃隆·马斯克表示,SpaceX 对美国政府资助合同的依赖将继续减少,这表明重点正在转移……
 时政The Guardi
时政
The Guardian World
活动人士闯入阿姆斯特丹微软数据中心建筑工地
原文:Activists break into building site of Microsoft datacentre in Amsterdam
围栏外和整个欧洲也采取了单独的行动,以强烈反对人工智能繁荣的影响 随着对人工智能繁荣造成的社会和环境危害的强烈反对蔓延到整个欧洲,活动人士冲进了阿姆斯特丹正在建造的微软数据中心的工地。荷兰直接行动组织 Geef Tegengas 的抗议者在闯入建筑工地时与警方发生冲突
非农就业数据远超预期,强化美联储加息预期,金价大跌至4,100美元下方
非农就业数据远超预期,强化美联储加息预期,金价大跌至4,100美元下方 www.tmgm.com
科技股历史性暴跌后,人工智能交易反弹
乔纳森·费罗(Jonathan Ferro)、丽莎·阿布拉莫维奇(Lisa Abramowicz)和安玛丽·霍登(Annmarie Hordern)每天与华尔街、华盛顿及其他地区的领导人和决策者交谈。没有其他程序比“彭博监控”更能在交易日为投资者和高管提供更好的定位。 (来源:彭博社)
巴拉圭为何面临银行业和政治危机?
上野倒塌引发了有关国家影响力和责任的质疑。
由于债务谈判遇到障碍,Braskem 股东撤回融资提议
据知情人士透露,巴西 Braskem SA 与其债权人之间关于庭外债务重组的谈判已经恶化,股东取消了注资提议。
美联储戴利:就业数据为收紧政策提供空间
美联储戴利:就业数据为收紧政策提供空间 www.tmgm.com
刚果民主共和国东部遭受埃博拉病毒袭击的村庄内武装人员造成至少 33 人死亡
当地人指责民主同盟军武装组织对北基伍村庄发动致命袭击,该组织于 2019 年宣誓效忠“伊斯兰国”。
Meta 推出 Spaces,这是一种与 Muse 代理协作的新方式
Meta 的 Muse 代理不断获得新功能和集成。 Spaces 有望成为与人工智能助手互动的新方式。
由于就业疲软,加元将迎来九月以来最糟糕的一周
加拿大就业数据弱于预期,加剧了对该国经济前景的担忧,加元有望录得自 9 月底以来的最大单周跌幅。
我的顾问推荐了年金。在这样的市场环境下,此举是否正确?
“我还没有致力于该战略,希望有一些独立的观点。”
大金主踩刹车?OpenAI新融资被曝遇冷、软银大幅缩减投入,CFO称中选后数据中心投资不变
OpenAI正面临新一轮融资的重大挑战。在10月末传出OpenAI将 融资目标调低100亿美元 的消息后,本周五又有《纽约时报》的报道称,多位主要投资方在本轮融资中大幅削减出资规模,软银等此前最积极的支持者此次仅计划投入数亿美元,与过往数百亿美元的投入相比不可同日而语。 据今年10月末的《金融时报》报道,OpenAI将本轮融资目标从最初的300亿美元削减至少三分之一,目前寻求融资规模约为200亿美元,估值也从最高1.5万亿美元下调至1.25万亿美元。据《纽约时报》DealBook本周五的报道,本轮OpenAI融资分两部分进行,第一部分截止日期为11月6日周五当天,预计实际募集金额将低于200亿美元。 同在周五,OpenAI首席财务官Sarah Friar在花旗TMT领导力峰会上接受CNBC采访时表示,尽管本周结束的中期选举中许多选民投票反对数据中心建设,OpenAI仍将继续推进数据中心基础
首席风险官再离职!实力券商合并后的"人才洗牌"
同一天,两份公告。 11月4日晚,国联民生同时披露两则消息:全资子公司民生证券参与国联期货换股吸收合并民生期货,民生期货解散注销,"一总部+八家专业子公司"架构就此收官; 同日,公司首席风险官江志强因工作调整辞职,辞职后不再在公司及控股子公司担任任何职务。由此带来了又一轮高管变动的契机。 谁是 江志强 ? 江志强生于 1970年,是原国联证券体系成长起来的高管,他历任证券投资部经理、营业部总经理、财富管理中心总经理、资产管理部总经理、公司总裁助理、公司副总裁、监事会主席等。自2021年5月起担任公司首席风险官。 简历可以看出,江志强长期的深耕领域就是投资线和经纪业务线。这体现出他相对专业和市场化的两面。 值得提及的是,江志强在国联证券体系中又属于 “老国联”,即不属于2015年后加入的有中信证券工作背景的“新国联人”,这为他的简历打下稳定、长期的标签。 从身兼数职到彻底离开 江志强曾 长期
 Th
Gnosis Pay 数据泄露导致客户信息泄露;资金不受影响
11 月 3 日,Gnosis Pay 披露了其旧借记卡系统未经授权访问后发生的数据泄露事件。客户资金未受影响。
 Ar
美国联邦航空局最终将在所谓的“历史性”技术升级中放弃软盘
到 2028 年底,FAA 信息显示系统将在 435 个地点实现无软盘化。
最高法院将听取高盛破产仲裁申请
美国最高法院同意审查高盛关于破产法院是否可以推翻仲裁协议的请求,从而对《联邦仲裁法》的影响力进行了高风险的测试。
随着肯尼亚上市数量的增加,Quick Mart IPO 吸引了强劲需求
作为肯尼亚第二大连锁超市,肯尼亚第二大连锁超市 Quick Mart Plc 完成了该国今年的第二次 IPO,其首次公开募股的股票需求量超出了现有数量近 23%。
数百个 Artex AI 黑客工具被发现公开暴露在网络上
安全研究人员发现数百台托管渗透测试工具 Artex 的服务器暴露在互联网上,允许任何人访问该黑客工具。
 De
美国和哥伦比亚军队在五角大楼转向西半球期间开始演习
随着美国军队加强对西半球的关注,数百名美国和哥伦比亚军队本周在哥伦比亚开始了一场规模庞大的军事演习。
 Th
《神奇女人》和《格洛丽亚》的导演塞巴斯蒂安·莱利奥去世,享年 52 岁
这位智利电影制作人在圣地亚哥的家中去世,享年 52 岁,其电影由弗洛伦斯·皮尤 (Florence Pugh)、朱丽安·摩尔 (Julianne Moore) 和蕾切尔·薇兹 (Rachel Weisz) 主演。继续阅读...
 Wi
中国的免费人工智能模型在黑客方面的能力越来越强
一项要求 AI 模型闯入模拟网络的实验表明,DeepSeek 和 GLM 的黑客技术与 OpenAI 最先进的网络模型(未公开)相差不远。
坦桑尼亚反对派领导人因“政治动机”案件被判入狱
坦桑尼亚反对派领导人通杜·利苏因一起被广泛谴责为出于政治动机的案件而被监禁。
为什么英国拒绝支付奴隶制赔偿?
英国补偿的是奴隶主,而不是被奴役的人。不加赔偿的道歉就够了吗?
要闻分析 - 特朗普:将很快决定是否恢复对伊朗大规模军事行动
要闻分析 - 特朗普:将很快决定是否恢复对伊朗大规模军事行动 RFI
特朗普的否决能否阻止民主党占多数?
民主党赢得了众议院和参议院。 AJLabs 着眼于这些数字以及这些数字对特朗普意味着什么。
Kevin Boone:使用 UEFI 进行裸机编程的第一步 – 系列索引
评论
 Te
AI 物理初创公司 PSI 表示,运行非公开人择模型的系统证明了 Aaronson-Ambainis 猜想,这是自 2008 年以来一直存在的量子计算问题 (PSI)
PSI:人工智能物理初创公司 PSI 表示,一个运行非公开人择模型的系统证明了 Aaronson-Ambainis 猜想,这是一个自 2008 年以来一直开放的量子计算问题 - Aaronson-Ambainis 猜想现在是一个定理。 — 自 2008 年开始,斯科特·阿伦森 (Scott Aaronson) 和安德里斯·安拜尼斯 (Andris Ambainis) 的猜想关注……
 r/
Mirage:一个 22 MB 的视觉语言模型,一次性运行场景描述 + 对象检测 + OCR + 分割 + 空间关系分析 + 提取 + 决策。
大家好,我是仙人掌计算公司的亨利。我们发布了 Mirage,这是一种适用于手机、可穿戴设备、机器人和其他消费设备的小型视觉模型。 Mirage 使用 22 MB 的权重文件运行场景描述、对象检测、OCR、分割、空间关系和决策。我们对三星 Galaxy S26 的端到端测量结果是,NPU 为 74 毫秒,CPU 为 107 毫秒,描述支持英语、G
Show HN:代理从来源推断乐高机制,然后将它们动画化
大家好 :) 大约一个月前,我发布了 LDraw Nova,这是一个通过生成 LDraw 源代码文件来组装乐高 CAD 模型的代理工具集。有关更多详细信息,请参阅 Show HN 帖子:https://news.ycombinator.com/item?id=49937916 从评论中,我得到的印象是,人们不仅对 AI 生成的乐高模型非常感兴趣,而且对 AI 动画乐高模型也很感兴趣。我看了一下
随着日本乡村空无一人,野生动物正在消失
文章网址:https://e360.yale.edu/digest/japan-depopulation-biodiversity 评论网址:https://news.ycombinator.com/item?id=50397264 积分:62 # 评论:32
 r/
尝试了麻省理工学院帖子中的权重编辑功能:一些很酷的应用程序,但没什么疯狂的
我采用了一些存在明显缺陷的模型(容易出现提示注入、静音时产生耳语幻觉等),并检查 Opus 5.5 是否可以通过编辑权重来修复它。它对于修补已完成训练且具有明显且易于阐明的缺陷的模型非常有用。所以这并不是什么疯狂的事情,当然也不是“人工智能可以自我编辑和递归改进”,但仍然非常有用。如果你愿意,请输入代码
Firecracker VM 逃生:PwnEscape 第 2 部分
文章网址:https://pwn.ai/blog/firecracker-escape 评论网址:https://news.ycombinator.com/item?id=50397219 积分:108 # 评论:59
我的第一封也是最后一封电报是丽贝卡·韦斯特发来的
文章网址:https://thelampmagazine.com/blog/rebecca-wests-nightingale 评论网址:https://news.ycombinator.com/item?id=50397176 积分:26 # 评论:6
 r/
bartowski/XingChen-AGI_Xing4.0-29B-A4B-GGUF · Hugging Face
您今天想尝试新的 29B MoE 吗? https://www.reddit.com/r/LocalLLaMA/comments/1xoqc59/add_support_for_the_xing4_0_by_shuxiaoqiong_pull/ Xing4.0-29B-A4B是Xing系列(原TeleChat)的下一代大型语言模型,由中国电信人工智能技术有限公司开发,总参数29B,每个token激活仅4B,原生支持256K c
 r/
SoMarkAI/OXR-1.0·抱脸
在浏览 HF 的热门型号时发现了上个月的型号。我没有看到任何现有的帖子。 OXR(Optical Everything Recognition)是 SoMark 团队的开源模型。它将 PDF 和文档图像转换为 Markdown 或 JSON 格式的代理友好数据,并包含布局坐标。 OXR 从头开始预训练,在训练后使用递归自我改进 (RSI) 循环
 Co
俄罗斯在 11 月 17 日推出之前敲定加密货币交易规则
该规则允许散户投资者通过受监管的中介机构交易 BTC、ETH 和 USDT,莫斯科交易所计划于 12 月推出加密货币交易。
 De
为什么一家流动性极高的国债公司想成为美国期货经纪商
Hyperliquid Strategies 已申请成为美国期货委员会商人,此举可能会让美国人在获得许可的 Hyperliquid 市场上交易永续期货,尚待监管部门批准。
 De
随着弹劾投票临近,巴拉圭对银行停业的抗议加剧
被上野银行拒之门外的储户烧毁了他们的卡,对人群中的一位前总统候选人发出嘘声,并目睹国会采取行动罢免佩尼亚总统。
1998 VS 2000,高盛主管:AI抛售更像LTCM危机而非互联网泡沫,但关键问题尚未解答
1998 VS 2000,高盛主管:AI抛售更像LTCM危机而非互联网泡沫,但关键问题尚未解答 华尔街见闻
 r/
Muir:具有灵敏度分配门控和匹配滤波器读出的线性注意力(Google Research,25MB 状态下的 10M 令牌)[R]
论文:https://arxiv.org/abs/2611.08376 | HF:https://huggingface.co/papers/2611.08376 在 10M 代币下,1.3B Transformer 需要 2.1 TB 的 KV 缓存(即使在 2.5 位量化时也需要 0.32 TB)。通道方式的门控增量模型(如门控 DeltaNet-2 / GDN-2)将历史记录压缩为固定的 25 MB 状态,但在 100B 令牌训练中遇到了 Muir 解决的三个瓶颈:100 倍慢通道眩光 -> 匹配
Futhark 中的非决定论
评论
论代理操纵政策
最近关于机器人操纵的工作主要集中在经过示范培训的专业政策上。我们证明,通才人工智能模型可以比视觉语言动作模型(VLA)和世界动作模型(WAM)等专业策略更可靠地控制操纵器。我们系统地分析了代理操纵策略(AMP),其中通用人工智能模型直接命令操纵器,
CPU-ARC:用于 CPU 推理重用的代理推理缓存
大型语言模型一直在重新发明轮子。他们将解决任务与执行解决方案混为一谈,这迫使他们从头开始解决每个问题。我们表明,一旦推理完成一项任务,就可以非常有效地将其解决方案应用于新的问题实例,并且几乎不需要语言模型的参与。我们引入代理推理cachin
关于 ReLU 网络集合的(非)封闭性
我们证明,对于有界连通开集 $Ω\subset\mathbb R^d$,具有一个隐藏层和至多 $N\in\mathbb N$ 个神经元的 ReLU 网络集合 $\mathcal{N}_N$ 在 $W^{1,p}(Ω)$ 中是弱闭的。因此,该空间上的每个强制的弱半连续能量在 $\mathcal{N}_N$ 上达到最小值。这涵盖了具有凸被积函数的 Deep Ritz 方法、Sobolev 训练和
FlowMoP:随机多人运动预测
预测多人的未来运动本质上是随机的:根据意图、协调和社会背景,相同的观察到的历史允许许多合理的延续。然而,多人 3D 运动预测的主导范例仍然是确定性的,现有方法为每个智能体生成固定数量的输出。相反,我们提出了一个条件流匹配 fr
关于测试时强化学习中多数投票伪标签的可靠性
测试时强化学习(TTRL)使用自行生成的伪标签将预训练的语言模型适应未标记的目标域数据,但其可靠性仍然知之甚少。我们通过在线直接偏好优化(DPO)分析了 TTRL 的多数投票监督,并将其误差分解为总体多数偏差和提示相关的有限推出变化。因为人口
分级卷积网络:无尺度的尺度不变性和对未知模糊的鲁棒性
图像的高斯射流是一个分级向量空间:$λ$ 的膨胀会将 $k$ 阶的导数乘以 $λ^{-k}$。局部分级卷积完全是齐次微分算子,并且局部特征是膨胀不变的,当且仅当它通过尺度归一化射流进行因子分解,或者在没有尺度的情况下,通过收缩到分级的加权球上。未知Ga下
CodeQuant2:针对低精度 LRM 的增强型异常值缓解和自适应聚类
大型推理模型(LRM)通过生成更长的中间推理轨迹来提高任务性能,但这大大增加了推理成本,并使低精度量化变得越来越重要。然而,激进的量化模型在推理任务上通常表现不佳。我们在推理的第一个解码步骤中观察到较大的激活波动。校准塔
GRAC:基于图形的手术场景描述检索增强字幕
目的:手术报告支持程序记录、手术培训、绩效评估和工作流程审查。然而,提取有意义的信息通常需要大量的人工审查和临床专业知识。自动化手术场景描述可以通过利用重复的手术活动和先验知识来减轻这种负担。方法:我们提出GRAC(图-