每个字节的性能更高:全栈协同设计如何解决人工智能的内存挑战
原文:More Performance From Every Byte: How Full-Stack Codesign Solves AI’s Memory Challenge
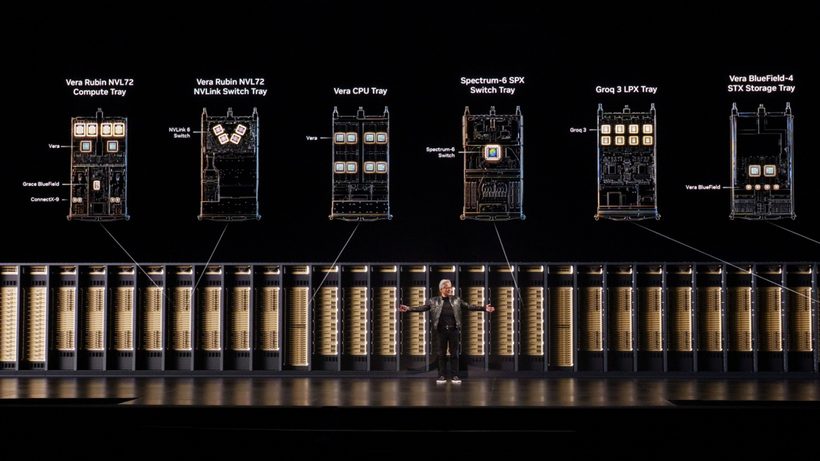
更大的模型、更长的上下文和代理应用程序正在增加 GPU 内存压力,同时供应紧张和价格上涨 - 这一趋势预计将在短期内持续下去。 NVIDIA 与内存合作伙伴密切合作,快速采用最新的内存技术。 NVIDIA 率先将 HBM3e 和 HBM4 技术采用到加速计算堆栈中。 […]
正在把原文抓到本机服务器…首次约 3~8 秒,抓好后本站永久缓存,下次秒开。
抓不到时可直接看原文(部分站点需要登录/反爬,服务器也无法抓取)。
正文由本站服务器抓取保存(已自动过滤广告、推荐位与追踪图片),排版与原站可能不同;版权归原站所有。