我们如何构建 TLX:用于大规模生产 ML 的硬件本机 GPU 编译器
原文:How We Built TLX: A Hardware-Native GPU Compiler for Production ML at Scale
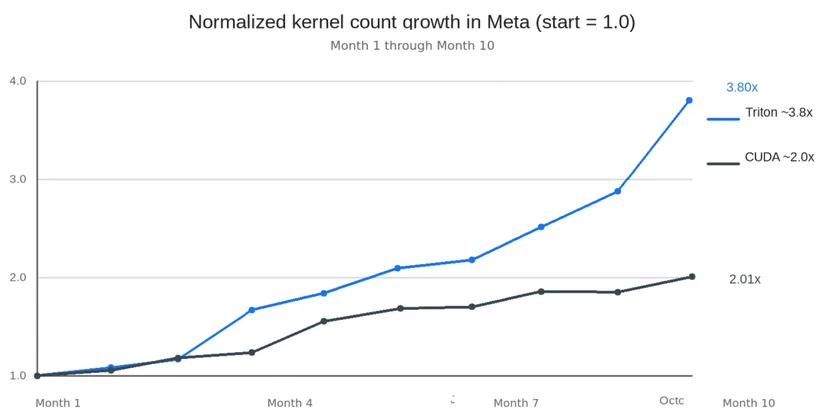
Triton 低级扩展 (TLX) 是 Triton 的扩展,可帮助工程师优化 GPU 性能,同时保留 Triton 的高效编程模型。 TLX 引入了显式扭曲组和集群级编排,使开发人员能够在不牺牲速度的情况下采用新的硬件功能。 TLX 在 RecSys 训练、RecSys 推理和
正在把原文抓到本机服务器…首次约 3~8 秒,抓好后本站永久缓存,下次秒开。
抓不到时可直接看原文(部分站点需要登录/反爬,服务器也无法抓取)。
正文由本站服务器抓取保存(已自动过滤广告、推荐位与追踪图片),排版与原站可能不同;版权归原站所有。