当一个 GPU 不够用时:使用 vLLM 在两个 NVIDIA DGX 站上提供 GLM-5.3 服务
原文:When One GPU Isn’t Enough: Serving GLM-5.3 Across Two NVIDIA DGX Stations with vLLM
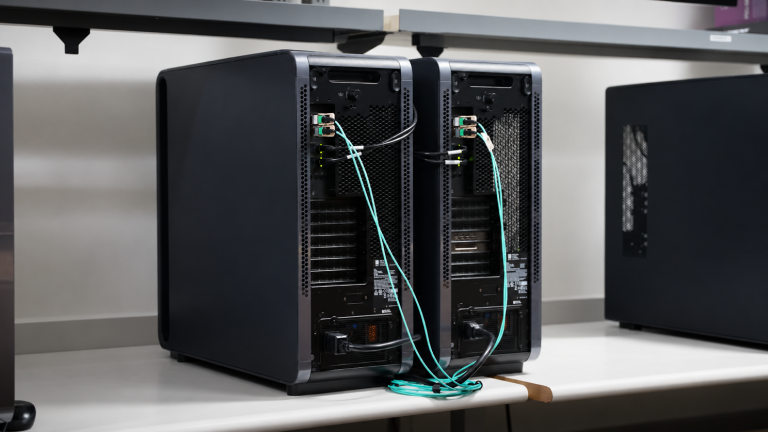
在本地运行前沿规模模型意味着将其所有权重保留在 GPU 内存中;最大的模型不再适合一台机器。两个 NVIDIA DGX 站...
正在把原文抓到本机服务器…首次约 3~8 秒,抓好后本站永久缓存,下次秒开。
抓不到时可直接看原文(部分站点需要登录/反爬,服务器也无法抓取)。
正文由本站服务器抓取保存(已自动过滤广告、推荐位与追踪图片),排版与原站可能不同;版权归原站所有。
