🔥 正在热议(多家媒体同时报道的事件)
 时政界面新闻
时政
界面新闻
在岸人民币兑美元收盘报6.6705
 财经华尔街见闻
财经
华尔街见闻
平头哥分拆上市值多少?大摩给出最高830亿美元估值
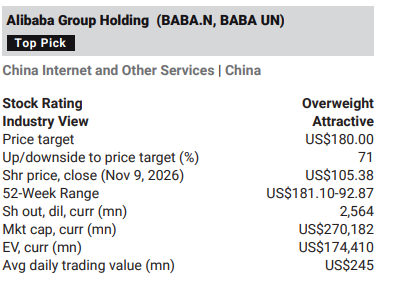
阿里巴巴旗下芯片部门平头哥的分拆上市计划,正在为这家中国科技巨头的估值打开新的想象空间。摩根士丹利分析师Gary Yu等在最新研报中给出平头哥独立估值区间 280亿至830亿美元 ,并认为此次分拆是释放阿里巴巴资产价值的重要催化剂。 阿里巴巴已正式提出将平头哥在香港上市,但具体发行细节尚未敲定。分析师指出,平头哥上市后将维持阿里巴巴子公司地位,阿里巴巴现有股东不享有平头哥股份的确定性认购权利。 平头哥目标是将其算力贡献占比从目前逾10%提升至40%至50%,以支撑阿里巴巴2032年实现20GW全球算力目标。 估值区间:280亿至830亿美元 分析师Gary Yu在研报中表示,平头哥的独立估值区间为280亿至830亿美元。在扣除30%控股折价后,对应阿里巴巴每股ADS的价值贡献约为7.6至22.7美元。 这个估值目前只体现在大摩对阿里SOTP(分类加总估值)的 高端情景 中,并未纳入其中性基
 时政法广中文
时政
法广中文
英伟达间谍风波,揭开了美中科技冷战中比较隐蔽的一面
美国科技巨头英伟达掌门人黄仁勋,承认自己曾与一名中国女子保持婚外情。美国情报部门怀疑这名女子为北京从事间谍活动。法国《世界报》经济版专栏记者伊莎贝尔·沙普龙周二从这一事件出发回顾了美中科技冷战中的往事。 相关的文章表示,涉及英伟达老板黄仁勋的这一事件,揭开了美中科技冷战中更加隐蔽的一面。
 加密CoinTelegr
加密
CoinTelegraph
SEC 执法行动下降 24%,加密货币案件成为焦点
原文:SEC enforcement actions fall 24%, crypto cases in spotlight
SEC 在 2026 财年提起了 348 项诉讼,低于上年同期的 456 项。案件包括涉嫌比特币挖矿欺诈和 FTX 审计和解。
和谈后美伊维持封锁不进攻,油价短期反弹风险_外汇动态报道
和谈后美伊维持封锁不进攻,油价短期反弹风险_外汇动态报道 汇通网
欧洲股市因矿业股和科技股上涨而创历史新高
由于油价普遍疲软和对人工智能贸易的热情重燃提振了市场情绪,欧洲股市攀升至新高。
离岸信托收益征税平稳有序推进
新华社北京11月11日电(记者刘开雄)记者11月11日从国家税务总局获悉,目前,离岸信托收益征税政策过渡期已平稳结束,绝大多数纳税人积极配合,累计申报离岸信托个人所得税超1600亿元,其中10月当月入库超1200亿元,带动了全国10月份个人所得税收入增长近90%。
美媒爆料:美财长因遭伊朗威胁已迁至军事基地居住
中新网11月11日电 据法新社援引《纽约时报》10日报道,美国财政部长贝森特因受到伊朗方面针对其人身安全的威胁,已从华盛顿地区的住所迁至一处军事基地居住。
 华尔
Anthropic IPO估值1.3万亿美元,创始人人均身家180亿美元
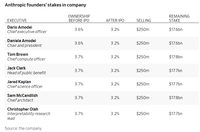
Anthropic正以硅谷近年来规模最大的IPO之一冲击公开市场,七位联合创始人将在上市后各自坐拥约180亿美元身家,彰显这家AI公司自2021年成立以来的惊人增长速度。 据华尔街日报报道,Anthropic周二(11月10日)提交的文件显示, Anthropic计划最快下周上市,目标估值约1.3万亿美元,拟通过股票发行及向谷歌等大型投资者定向配售相结合的方式,募资约800亿美元或更多。 此次IPO发行价区间定为每股70至78美元。 七位创始人各自计划在IPO中套现约2.5亿美元,出售约340万股。上市后,每位创始人仍将持有公司约3.2%的A类股份,按发行价区间中点计算, 对应市值约为180亿美元,七位创始人合计持股比例约为22% 。 据PitchBook数据,Anthropic在今年5月的融资轮中估值约为9650亿美元,此次IPO目标估值较彼时进一步大幅跃升。 七位创始人:从OpenAI
尽管局势紧张,巴基斯坦从印度的进口如何再次增长?
从形式上来说,他们根本不进行交易。但巴基斯坦从印度的进口已恢复至战前水平。接下来会解冻吗?
普京尚未准备好在阿布扎比实现和平
这位俄罗斯领导人仍然相信,他能够超越西方对乌克兰的支持。
多元发展向绿向智 进博会折射新能源汽车产业新动向
原标题:财经聚焦·第九届进博会|多元发展向绿向智 进博会折射新能源汽车产业新动向
大马第3季失业率3% 196万高学历者大材小用
大马第3季失业率3% 196万高学历者大材小用 www.chinapress.com.my
 华尔
英伟达Rubin Ultra将催生多少CPO需求?伯恩斯坦:单Pod光学价值量翻5倍
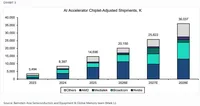
英伟达下一代AI芯片架构所催生的共封装光学(CPO)需求,正推动光学通信行业进入一个规模远超当前预期的新增长周期。 据追风交易台消息,据伯恩斯坦分析师Daniel Zhu在最新研报中测算,基于Coherent披露的每100 Tbps芯片对应1.5万美元内容价值这一数据, 一个8机架Rubin Ultra计算集群(Pod)所产生的光学内容机会约达540万美元,较此前Vera Rubin NVL72架构下约100万美元的规模扩大逾5倍。 结合伯恩斯坦亚洲半导体团队(Mark Li)的出货量预测,这意味着Coherent在英伟达Rubin Ultra平台上的市场机会2027年约为94亿美元,2028年将进一步扩大至361亿美元。 若将整个英伟达生态系统纳入统计,2028年光学市场总规模或接近470亿美元,同比增长91%。 伯恩斯坦维持Lumentum、Coherent和Ciena的"跑赢大市"评
 华尔
科技老将:Anthropic IPO将是美股AI行情高点,有机会就“大举做多中国AI”
在AI热潮推动下,Anthropic正筹备一宗规模高达1000亿美元的IPO,但一位长期看空AI的科技老将发出警告:Anthropic IPO可能成为AI行情高点,禁售期届满后或引发连锁式回调。 创投公司Copper Sky负责人、Peter Thiel家族办公室管理合伙人Jack Selby周三接受彭博电视采访时表示,“如果这家最受期待的AI公司IPO远远低于预期估值,想象一下锁定期到期之后会发生什么。一场表现不佳的Anthropic IPO,必将成为AI市场一场相当大规模回调中的核心推手。” Anthropic目前正寻求通过IPO、私募配售及潜在超额配售选择权,合计筹资最多1000亿美元。初步迹象显示市场需求强劲,据报道发行规模甚至可能进一步扩大。但Selby对此并不买账。 Selby一年多前便曾公开表示,围绕AI产业的狂热可能是私人科技投资领域迄今最大的泡沫。 此番他再度发声,从估值
靖国神社“秘录”公开,戳穿日本右翼的隐秘算计(环球走笔)
刘文璋
外媒聚焦COP31:中国积极参与全球气候治理,助力全球绿色转型
中新网11月11日电 11月9日至20日,《联合国气候变化框架公约》第三十一次缔约方大会(COP31)在土耳其南部城市安塔利亚举行,此次大会吸引全球目光。多家外媒认为,中国为应对气候变化作出重要贡献,中国积极参与全球气候治理,推动全球绿色发展。
工商银行:向特定对象发行A股股票申请获上交所审核通过
工商银行:向特定对象发行A股股票申请获上交所审核通过 新浪网
答题闯关!21个经济体“线下见面”,这个“群”的群规你摸清了吗?
APEC第三十三次领导人非正式会议即将在深圳启幕。21个经济体要“线下见面”了,这个“群”的群规你摸清了吗?
西部证券曹柳龙:中长期对A股市场不必悲观 改革显效蓝筹估值不高
西部证券曹柳龙:中长期对A股市场不必悲观 改革显效蓝筹估值不高 观点网
农业银行:定增A股股票申请获上交所审核通过
农业银行:定增A股股票申请获上交所审核通过 新浪网
Adler Pelzer 正在与投资基金谈判以完成再融资
Adler Pelzer Holding GmbH 正在与投资基金就替代资金来源进行谈判,希望尽快达成再融资协议。
金价、油价、银价,有变!
金价、油价、银价,有变! Sohu
CoreWeave 为多头开了绿灯:市场分析
安娜·爱德华兹 (Anna Edwards)、汤姆·麦肯齐 (Tom Mackenzie) 和马克·库德莫尔 (Mark Cudmore) 在“彭博社:开盘交易”中为分析师和投资者分析了今天的关键主题。 (来源:彭博社)
奇瑞因安全问题在南非召回数千辆汽车
中国汽车制造商奇瑞南非公司召回了数千辆汽车以检查是否存在潜在故障,该国消费者监管机构表示已对该公司展开调查。
 界面
有研粉材:公司光伏用铜粉产品处于技术验证阶段
有研粉材11月11日在互动平台表示,公司光伏用铜粉产品处于技术验证阶段,公司密切关注和跟进光伏行业去银化降本发展动态,匹配终端实际开发进度和量产需求。
 界面
7部门29条举措提升工程师队伍创新创造能力
人力资源社会保障部、工业和信息化部等七部门日前发布29条举措,提出支持开展线上线下培训、学术技术交流等10种继续教育方式,鼓励支持用人单位和社会力量探索应用“人工智能+”继续教育新范式,提升工程师解决工程技术难题的专业能力、创新能力、实践能力和职业素养。
防水龙头,不白交学费_公司新闻_财经
防水龙头,不白交学费_公司新闻_财经 证券之星
 界面
化妆品,从研发到上市有多难?
一款新原料的“万里长征”。
界面
ST中路:朱智恢复履行董事会秘书职责
内地青年失业潮催生商机 30元即可租工位“假上班”还包拍工作照
内地青年失业潮催生商机 30元即可租工位“假上班”还包拍工作照 香港01
AI数据中心挤占成熟制程产能,汽车芯片供应链面临瓶颈
AI数据中心挤占成熟制程产能,汽车芯片供应链面临瓶颈 凤凰网科技
据报SpaceX自研Kessel机架 仅向英伟达采购芯片封装
据报SpaceX自研Kessel机架 仅向英伟达采购芯片封装 观点网
为什么中国1万亿美元的贸易顺差对其经济来说并不都是好消息
蓬勃发展的出口掩盖了中国人的节俭观念,这可能会损害长期增长。
伊朗否认与美国会谈,称霍尔木兹将保持关闭,直到满足要求
穆赫森·雷扎伊发表此番言论之际,伊朗伊斯兰革命卫队表示,至少有三艘船只在霍尔木兹海峡触雷并起火。
今天A股,“独立”了!
今天A股,“独立”了! 21财经
油价调整通知!不要着急加油
油价调整通知!不要着急加油 Sohu
日本最危险的军事限制是时间
在我进行的 2022 年兵棋推演中,双边规划者遇到了一个熟悉的障碍。美军需要在对手发起第一次导弹齐射之前从集中基地撤离。与会者认为,日本只有在遭受袭击后才能紧急进入私人土地,但为时已晚——当局的触发点也是其最后期限。这似乎是一个硬性的政治约束:
硅光芯片赛道再获大额融资!
硅光芯片赛道再获大额融资! 电子工程专辑EE Times China
安世半导体与意法半导体称AI数据中心需求挤占成熟制程产能,汽车芯片供应链出现瓶颈
安世半导体与意法半导体称AI数据中心需求挤占成熟制程产能,汽车芯片供应链出现瓶颈 网通社
Qwen4-Max 预览版已不再支持 API 访问。目前还没有关于重量释放的消息
我他妈不知道,比人们说的 opus 5 和 6.1 terra 还要好。我们将看到 /u/Dany0 [链接] [评论] 提交的内容
 r/
qwen4-max-在 qwencloud 上预览
遗憾的是找不到更多详细信息,但看起来像“发布开始” https://www.qwencloud.com 由 /u/Evening_Ad6637 提交 [链接] [评论]
关于互联网新技术新应用信息服务备案系统上线的通告-政企通
关于互联网新技术新应用信息服务备案系统上线的通告-政企通 湖南省人民政府
CERN 如何为 LHC 研发下一代磁体
CERN 的大强子对撞机(LHC)利用极其强大的磁体,使粒子接近光速发生碰撞,将粒子撞碎成更小的组成部分以供研究。当前状态下的 LHC 每秒能让约 60 个粒子发生碰撞,碰撞频率高达每秒 4000 万次。这一能力已经促成了本世纪粒子物理学领域一些最重要的发现。CERN 的科学家并没有止步。他们正对 LHC 进行升级,为计划于 2030 年之后开始的实验做准备。新一代粒子对撞机被称为高亮度大型强子对撞机(High-Luminosity LHC 或 HL-LHC),高亮度指的是粒子碰撞数量的增加。CERN 的目标是每次实验将碰撞涉及的粒子数量提高到 140-200 个,增加观测到罕见粒子或特殊物理现象的机会。为实现这一目标,对撞机需要配备体积极其紧凑、性能优异的磁体。目前对撞机使用的偶极磁体内部装有由铌钛合金(NbTi)制成的线圈,其磁场强度可达到 8.3 特斯拉。这一强度约为地球磁场的 16
比特币价格预测:衍生品市场杠杆攀升,BTC面临剧烈波动风险
比特币价格预测:衍生品市场杠杆攀升,BTC面临剧烈波动风险 www.tmgm.com
 Cr
Coinbase 赢得国家信托宪章,并适用严格的 OCC 指令
OCC 授权于 11 月 9 日开设账户并批准逐步进行账户转账,但客户级别的迁移时间尚未披露。阅读 CryptoSlate 上的完整故事 了解重要的加密故事以及接下来要观看的内容。将催化剂放入您的收件箱
Linux 上路由查找的性能演变
评论
b12284:CUDA:添加 OCP FP8 支持 (#28413)
初始 CUDA WIP 版本 使用 fp8 内在函数 在 GEMV 案例中为 FP8 执行 W8A16 (base) osimons@ub-osimons:~/lcpp_fp8.git$ ./build-x64-linux-gcc-reldbg/bin/llama-bench -m /mnt/share/gguf/nvidia/Qwen3.6-27B-NVFP4/Qwen3.6-27B-NVFP4_fp8.gguf -p 8196 -ub 512,2048 -d 0,32000 -n 256 --load-mode dio ggml_cuda_init: 找到 1 个 CUDA 设备 (总 VRAM: 32165 MiB):设备 0:NVIDIA RTX PRO 4500 Blackwell,计算卡
[中国新闻网]第三届纪检监察学科建设高端论坛在中国人民大学举办
[中国新闻网]第三届纪检监察学科建设高端论坛在中国人民大学举办 人大新闻网
b12285: cuda : fattn mma 头部尺寸 40 72 (#30285)
cuda:添加对头部尺寸 40 和 72 的 MMA FlashAttention 支持 头部尺寸 40 和 72(例如在 Gemma 3/4 和 Qwen3-VL 的视觉塔中使用)被从每个张量核心调度分支中排除并回落到图块内核。 fp16 MMA 片段在头部方向上覆盖了 16 个一半,因此内核内的几何形状被填充到下一个 16 的倍数(40 -> 48、72 -> 80)。寄存器数组、共享备忘录
两部门:到2030年人工智能深度融入自然资源管理全链条
两部门:到2030年人工智能深度融入自然资源管理全链条 中国新闻网
邻居的标签:下一幕评估中相同对话暴露的相反子群效应
基于窗口的下一步评估通常旨在衡量对话之间的泛化性,但重叠窗口和相似性检索可以暴露测试对话中的标记示例。最接近的这样的例子是目标的标记前任,当目标继续它时,其行为是正确的,而当目标改变行为时,其行为是错误的;复制它的模型可以在两个子组中获得和损失